
¿Por qué mi área de auditoría frena los proyectos de IA y no los de RPA?
Porque el resultado varía. Un robot de RPA ejecuta reglas predefinidas sobre campos y rutas conocidas: si le das la misma factura dos veces, hace lo mismo dos veces. Una automatización con IA generativa puede dar resultados distintos según el modelo, su versión, el contexto recuperado, el prompt, la temperatura, los datos de entrada y cambios que haga el proveedor sin avisarte.
Eso cambia la pregunta de auditoría. Con RPA basta reconstruir entrada, regla y salida. Con IA hay que reconstruir además qué información vio el modelo y cómo se generó la respuesta. Cuando el equipo de auditoría interna dice "no puedo opinar sobre esto", casi nunca está objetando la IA: está diciendo que no hay evidencia para reconstruir una decisión.
Y el riesgo se amplía según lo que la automatización pueda hacer. Si puede disparar pagos, modificar expedientes, enviar comunicaciones o decidir sobre personas, el problema deja de ser operativo y toca privacidad, discriminación, propiedad intelectual y responsabilidad. McKinsey identifica la inexactitud como el riesgo de IA generativa que con mayor frecuencia ha producido consecuencias negativas, junto con ciberseguridad y propiedad intelectual.
Hay un antecedente útil: en 2023, 53% de las organizaciones reconocía la ciberseguridad como riesgo relacionado con la IA generativa, pero solo 38% decía estar trabajando para mitigarlo. La brecha entre "sabemos que existe" y "estamos haciendo algo" es exactamente lo que auditoría intenta cerrar. En la edición global publicada el 12 de marzo de 2025, McKinsey ya reportaba más actividad de mitigación frente a inexactitud, ciberseguridad e infracción de propiedad intelectual que a comienzos de 2024.
Criterio propio: no lleves a comité un proyecto de IA sin el diseño de evidencia resuelto. Es más rápido discutir el expediente de ejecución en la fase de diseño que agregarlo después, cuando ya hay un flujo en producción y nadie sabe qué pasó la semana pasada. Si vienes de la discusión general de arranque, conviene leer primero cómo empezar con IA y automatización en una empresa mexicana.
¿Qué significa "trazabilidad" en una automatización con IA, en términos concretos?
Es una lista de campos, no un principio. Para cada ejecución, el sistema debería conservar como mínimo:
- Identificador único de la solicitud, caso o transacción, más fecha, hora, usuario y sistema de origen y destino.
- Datos de entrada, con clasificación de qué es información personal o confidencial.
- Versión del prompt, plantilla o instrucciones.
- Modelo, proveedor, versión y parámetros relevantes.
- Documentos o registros recuperados: identificador, versión, fecha y el fragmento que realmente se usó.
- Puntuación de recuperación o indicadores de confianza disponibles.
- Salida generada y acción ejecutada en el sistema destino, con su reversión o excepción si aplica.
- Intervención humana: aprobador, decisión, comentario, fecha y qué cambió.
A esos ocho se les suman dos que casi nadie pide y luego se extrañan: las reglas de validación, filtros y políticas aplicadas en esa corrida, y el costo de la ejecución (tokens, llamadas, almacenamiento). El costo no es un dato contable nada más: es el que te permite detectar que un flujo se volvió caro porque alguien cambió el prompt y ahora manda el triple de contexto.
Así se ve una fila de bitácora en un flujo de clasificación de documentos de proveedor:
| Campo | Valor de ejemplo |
|---|---|
| id_ejecución | EJ-2026-10-04417 |
| fecha / origen | 2026-10-09 11:42 / portal web |
| entrada | archivo "constancia_fiscal.pdf", clasificado como dato fiscal de persona moral |
| prompt | plantilla clasif-docs v3.2 |
| modelo | proveedor X, versión fija 2026-06, temperatura 0.1 |
| recuperado | política-proveedores v8 (frag. 4), catálogo-docs v2 (frag. 1) |
| puntuación | 0.81 / 0.64 |
| salida | "constancia de situación fiscal · vigente" |
| acción | expediente actualizado, estatus "en revisión" |
| humano | analista de compras, aprobado sin cambios, 11:51 |
| costo | costo estimado de la ejecución (tokens más almacenamiento); es un campo ilustrativo, el valor depende de tu proveedor y de tu volumen |
Esa bitácora debe ser inmutable o protegida contra alteraciones, con control de acceso, retención definida y capacidad de exportarse. Si cualquiera del equipo puede editar un registro de aprobación, la bitácora no sirve como evidencia. Esto se cruza con el resto de tus controles de acceso y registro; vale revisarlo junto con tu postura de ciberseguridad.
Esta estructura es una especificación de control operativo, no una obligación vigente. Dicho eso, las iniciativas legislativas mexicanas de 2025 describen algo muy parecido: una iniciativa presentada el 30 de abril de 2025 propuso que los sistemas de IA de alto riesgo conservaran un registro técnico continuo, cronológico, auditable y seguro de operaciones, decisiones, entradas y salidas. Si diseñas hoy con estos campos, no te va a tomar por sorpresa.
¿Cómo se demuestra de dónde salió una respuesta (citas, RAG y búsqueda híbrida)?
Con citas reproducibles. Una respuesta sin cita a la fuente no es auditable: es una opinión con buena redacción. Y una cita que solo dice el nombre del documento tampoco alcanza, porque no permite reproducir la respuesta si el documento cambió.
Una cita utilizable incluye documento de origen, identificador del archivo, versión, página o fragmento, fecha de recuperación y quién o qué proceso la consultó.
En un sistema RAG —el modelo responde después de recuperar información de una base documental— el expediente debe guardar también: la consulta original y la reformulada, el índice y su versión, los documentos recuperados con su puntuación, los fragmentos que de verdad se enviaron al modelo, el prompt final, la respuesta con sus citas y, cuando importe evaluar cobertura, los documentos que se descartaron. Si quieres el detalle de cómo se arma esa base, está en la guía de RAG para empresas en México.
La búsqueda híbrida combina búsqueda léxica por palabras clave, búsqueda semántica con vectores, filtros por metadatos y reordenamiento de resultados. Para auditar hay que registrar qué métodos se usaron, con qué parámetros y cuál fue el orden final. Sin eso puedes mostrar una cita, pero no demostrar que el sistema recuperó de forma consistente la evidencia que sí existía.
En ITECHDEV esto no es teoría de folleto: usamos internamente ARIA, nuestra memoria de conocimiento con búsqueda híbrida —texto completo más búsqueda semántica con pgvector—, para que el equipo consulte decisiones y documentación. Sobre ese mismo motor está construido Cítalo (citalo.ai), nuestro asistente de IA que responde con base en los documentos y datos del negocio y que hoy opera con 2 clientes. En los dos casos, la cita a la fuente es el mecanismo de trazabilidad: si la respuesta no puede apuntar a un documento, el usuario lo ve.
¿Qué pasa cuando el documento fuente cambia? Es el punto que más se descuida. Si tu índice se reconstruye y pierdes la versión anterior, una respuesta de hace tres meses queda sin respaldo verificable aunque la bitácora exista. Hay dos caminos: conservar versiones del documento y del índice, o al menos guardar el fragmento exacto que se envió al modelo junto con su fecha. Lo segundo es más barato y suele ser suficiente para una auditoría interna.
¿Dónde debe quedarse el humano en el proceso y cómo se registra su aprobación?
El humano se queda donde el impacto es material, jurídico, financiero o sobre derechos de personas. Casos donde la aprobación humana no se negocia:
- contratación, despido o evaluación de personal;
- crédito, seguros o asignación de límites;
- atención de reclamaciones;
- pagos, transferencias y cambios de datos bancarios;
- decisiones sobre clientes o proveedores;
- envío de comunicaciones legales;
- modificación o eliminación de datos;
- cualquier acción irreversible o difícil de revertir;
- casos con baja confianza, fuentes en conflicto o datos incompletos.
Fuera de esa lista, usa tres modos: automático (bajo impacto y reversible), aprobación obligatoria (impacto material) y muestreo (alto volumen, bajo impacto, se revisa un porcentaje fijo y se ajusta según el error detectado). El error típico es poner aprobación en todo: el aprobador se convierte en un botón de "aceptar" y la evidencia pierde valor porque nadie revisó nada.
El registro de aprobación debe incluir identidad y rol del aprobador, qué información recibió, la respuesta y las fuentes que se le mostraron, la decisión (aprobar, rechazar, modificar, escalar), el motivo, fecha y hora, los cambios hechos y el resultado posterior. Ese "qué información recibió" es el campo que salva la discusión: sin él, el aprobador siempre podrá decir que no vio el dato relevante.
Un ejemplo de nuestro trabajo: en el portal de proveedores y cotizaciones de CAINTRA hay clasificación asistida por IA, dentro de un portal único donde además se cotizan servicios y se cobran membresías a las afiliadas. Está publicado en el caso CAINTRA. Como criterio general —nuestro, no atribuible a ningún cliente—, el patrón que mejor sobrevive a una revisión es el mismo: IA que propone y clasifica, humano que confirma en los puntos de impacto, con la confirmación registrada.
¿No sabes si esto aplica a tu empresa? Haz el diagnóstico gratuito de 3 minutos.
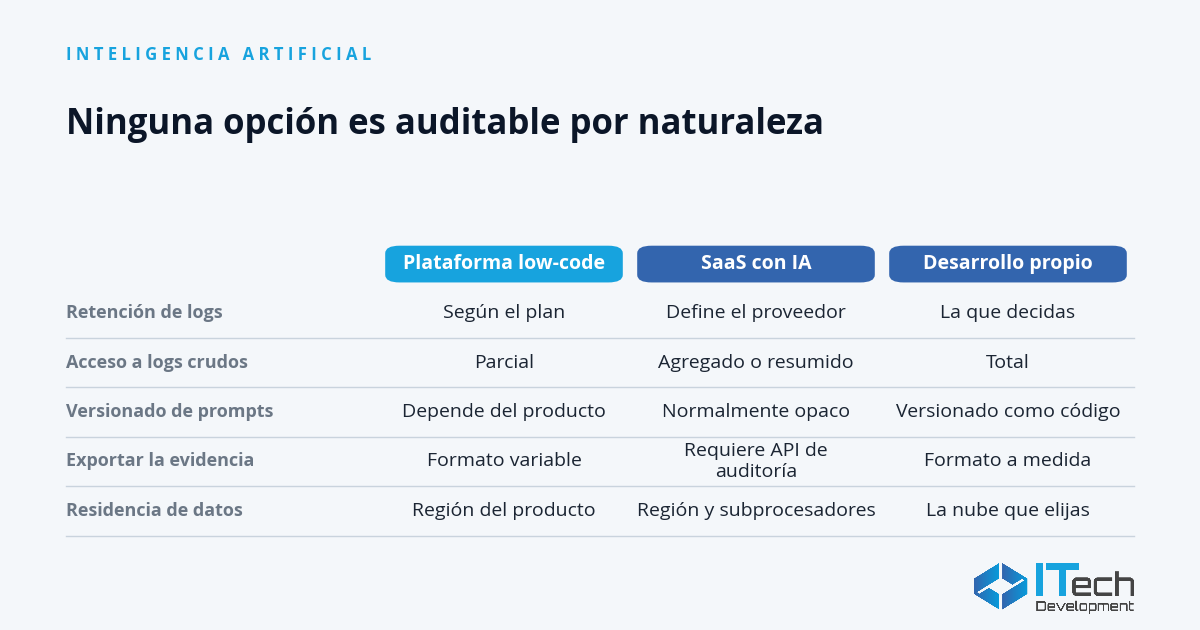
¿Qué tan auditable es cada opción: plataforma low-code, SaaS con IA o desarrollo propio?
Ninguna de las tres es auditable por naturaleza. Lo que cambia es cuánta evidencia te deja ver y cuánto control tienes sobre ella.
| Criterio | Plataforma low-code | SaaS con IA | Desarrollo propio |
|---|---|---|---|
| Retención de logs | Según el plan del producto; suele ser limitada | Definida por el proveedor; hay que leerla en el contrato | La que tú decidas y pagues |
| Acceso a logs crudos | Parcial; a veces solo el log del flujo, no el del modelo | Frecuentemente agregado o resumido | Total |
| Versionado de prompts y flujos | Depende del producto; a veces hay historial, a veces no | Normalmente opaco: el prompt es del proveedor | Tú lo versionas como código |
| Datos que salen a un modelo externo | Visible a nivel conector, no siempre a nivel campo | Hay que preguntar por subprocesadores y uso para entrenamiento | Decides qué se envía y qué se enmascara |
| Exportabilidad de la evidencia | Exportación de logs, formato variable | Requiere API de auditoría; no todos la tienen | Exportas en el formato que necesite auditoría |
| Residencia de datos | Según región del producto | Según región y subprocesadores del proveedor | La que elijas en tu nube |
Qué se gana y qué se pierde, sin adorno:
- Low-code: arrancas rápido y auditas bien el flujo (quién, cuándo, qué conector). Donde se queda corto es en el detalle del modelo y del prompt. Conviene cuando el proceso es de bajo impacto y lo que quieres demostrar es la secuencia, no el razonamiento.
- SaaS con IA: puede traer citas y registros de actividad listos, y eso vale mucho. El riesgo es que cambien el modelo sin notificarte y que no puedas fijar una versión. Exige por contrato retención, ubicación de datos, subprocesadores, uso de datos para entrenamiento, borrado y API de auditoría.
- Desarrollo propio: control completo sobre arquitectura, logs, RAG y aprobaciones. El costo es que la responsabilidad del gobierno de modelos, el monitoreo, las pruebas y la operación es tuya. Un sistema propio sin registros es menos auditable que un SaaS con trazas completas; verlo al revés es el autoengaño más común.
Cuándo NO conviene desarrollo propio: si el proceso es estándar, de bajo impacto y tu equipo no va a sostener monitoreo ni pruebas de calidad. Cuándo SÍ: cuando el dato es sensible, la decisión afecta a terceros o necesitas reproducir ejecuciones viejas. En nuestra experiencia construyendo a la medida —por ejemplo, el sistema de Certior sobre Azure, modelado sobre su forma real de operar, publicado en el caso Certior— el valor aparece cuando el proceso es propio y no cabe en un producto de catálogo.
Si lo que estás evaluando son agentes que ejecutan acciones y no solo responden, la exigencia de evidencia sube: revisa también qué son los agentes de IA para empresas.
¿Qué preguntas hacerle al proveedor antes de firmar?
Seis preguntas y la respuesta que deberías aceptar:
- ¿Qué campos registra cada ejecución y me los puedes enseñar hoy? Respuesta aceptable: te muestran un registro real en pantalla con prompt, modelo, versión, parámetros y documentos recuperados. Si te dicen "tenemos logs" sin mostrarlos, no cuenta.
- ¿Cuánto tiempo guardan los logs y en qué formato me los entregan? Aceptable: un plazo escrito en el contrato y exportación estructurada (CSV o JSON) sin costo adicional por evento.
- ¿Puedo reproducir una ejecución de hace tres meses? Aceptable: sí, porque conservan versión de prompt, versión de modelo y el fragmento recuperado. Si el modelo ya no existe, que te digan cómo documentan ese cambio.
- ¿Quién es responsable del tratamiento, qué subprocesadores intervienen y mis datos entrenan modelos? Aceptable: una lista de subprocesadores, la ubicación de procesamiento y un "no" por escrito sobre entrenamiento, o la opción de desactivarlo.
- ¿Cómo se versiona y aprueba un cambio de prompt o de modelo? Aceptable: hay historial, autor, fecha y un proceso de aprobación; y te notifican antes de cambiar la versión del modelo. Pregunta explícitamente si puedes fijar una versión.
- ¿Qué pasa con mis datos y mis logs si cancelo? Aceptable: plazo de exportación, formato y constancia de borrado.
Agrega dos de cierre: ¿se puede configurar aprobación humana obligatoria por tipo de caso? y ¿qué mecanismos de apagado y reversión existen? Si la respuesta a cualquiera de las dos es vaga, el proyecto no está listo para tocar un proceso con dinero.
Error común: hacer estas preguntas al área comercial y aceptar la respuesta verbal. Pide que las respuestas queden en el anexo técnico del contrato. Lo que no está escrito no existe cuando llega la auditoría.
¿Cómo mido si la automatización está funcionando (y cuándo apagarla)?
Primero el baseline. Antes de automatizar, mide el proceso como está: tiempo de ciclo, errores detectados, volumen, costo por caso. El error más caro que vemos es automatizar sin línea base y luego presentar "ahorro" sin evidencia; cuando finanzas pide el cálculo, el proyecto se cae solo.
Después, cuatro familias de métricas:
- Calidad: exactitud frente a un conjunto validado, porcentaje de respuestas con citas, porcentaje de citas que de verdad respaldan la afirmación, tasa de respuestas sin evidencia suficiente.
- Operación: tasa de escalamiento a humano, porcentaje de aprobaciones que el humano modificó, errores por cada 1,000 ejecuciones, tiempo de ciclo, disponibilidad y latencia.
- Riesgo: incidentes de privacidad o seguridad, porcentaje de automatizaciones revertidas.
- Valor: costo por caso y ahorro o ingreso atribuible.
La métrica que más información da es el porcentaje de aprobaciones modificadas. Si es cercano a cero durante semanas, o el modelo es muy bueno o nadie está revisando; en ambos casos hay que cambiar el diseño.
Define el umbral de apagado antes de lanzar. Disparadores razonables: aumento significativo de errores, caída en la cobertura de citas, más respuestas sin evidencia, uso de una fuente vencida, fuga o exposición de datos personales, cambio no aprobado del modelo, costo por transacción por encima del límite o una acción irreversible ejecutada sin aprobación.
Y que el apagado sea real: desactivar el flujo, bloquear las acciones de alto impacto, conservar los logs, notificar al responsable, abrir la revisión y revertir lo que se pueda revertir. Un "apagado" que requiere tres días y un ticket no es un control.
¿Qué cuesta sumar trazabilidad y qué obligaciones legales aplican en México?
No hay una tarifa de mercado verificable para México en 2026, y cualquier porcentaje único sería inventado: depende del volumen de ejecuciones, los datos tratados, la retención, el número de usuarios, el modelo, el nivel de servicio y el alcance de la auditoría. Lo que sí se puede listar es dónde se va el esfuerzo:
- instrumentación de logs y metadatos;
- almacenamiento y retención;
- indexación documental y búsqueda híbrida;
- evaluación de calidad y conjuntos de prueba;
- controles de identidad y acceso;
- monitoreo y alertas;
- revisión legal y de privacidad;
- integración con sistemas corporativos;
- operación humana de excepciones;
- auditorías y pruebas periódicas.
Criterio práctico: el bloque más barato es la bitácora y el versionado de prompts, porque es trabajo de ingeniería que se hace una vez. El más caro de mantener es la evaluación de calidad, porque requiere un conjunto de prueba vivo y gente que lo revise. Si tienes que recortar, recorta en paneles bonitos, no en el conjunto de prueba.
Del lado legal, con las fuentes disponibles se sostiene esto:
- La LFPDPPP aplica cuando la automatización trata información de una persona identificada o identificable. Hay que definir la finalidad del tratamiento y comunicarla en el aviso de privacidad. Una publicación del 23 de julio de 2026 señaló que las empresas que procesan información de personas identificadas o identificables ya están sujetas a la legislación mexicana de protección de datos.
- Según la guía de Chambers del 21 de mayo de 2026, en México no existían obligaciones legales generales específicas para sistemas agénticos sobre supervisión humana, logging, auditabilidad o explicabilidad, ni un régimen específico de transparencia para chatbots, contenido generado por IA o modelos fundacionales.
- Durante 2025 y 2026 se presentaron iniciativas que incorporan riesgo, auditoría algorítmica, trazabilidad, supervisión y registros técnicos continuos. La de abril de 2025 definió la trazabilidad como mecanismo para atribuir responsabilidades, corregir errores, evaluar el comportamiento del sistema y validar cumplimiento. Son iniciativas: no equivalen a ley vigente.
- Las obligaciones concretas cambian según sector, contrato, tipo de dato, autoridad supervisora y efecto de la decisión. Lo que aplica a un banco no aplica igual a una comercializadora.
¿Cuándo conviene mantener el modelo o la base documental en tu propia nube? Cuando tratas datos personales sensibles, cuando el contrato con tu cliente te obliga a residencia específica, o cuando necesitas conservar versiones de índice por años. Cuando no es el caso, un servicio administrado con un contrato bien revisado es más rápido y suele ser suficiente.
Fuentes
- The state of AI: How organizations are rewiring to capture value (McKinsey, 12 de marzo de 2025) — https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai-how-organizations-are-rewiring-to-capture-value
- Responsible AI: Overcoming adoption barriers and risks in the agentic era (McKinsey) — https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/tech-forward/state-of-ai-trust-in-2026-shifting-to-the-agentic-era
- Cybersecurity in the age of generative AI (McKinsey) — https://www.mckinsey.com/featured-insights/themes/cybersecurity-in-the-age-of-generative-ai
- Artificial Intelligence 2026 – Mexico: Trends and developments (Chambers, 21 de mayo de 2026) — https://practiceguides.chambers.com/practice-guides/artificial-intelligence-2026/mexico/trends-and-developments
- México regula la inteligencia artificial por sectores mientras aplaza la ley general (El Economista, 23 de julio de 2026) — https://www.eleconomista.com.mx/tecnologia/mexico-regula-inteligencia-artificial-sectores-aplaza-ley-general-20260723-824716.html
- Iniciativa con proyecto de decreto por el que se expide la ley… (30 de abril de 2025) — http://sil.gobernacion.gob.mx/Archivos/Documentos/2025/04/asun_4896460_20250430_1747757009.pdf
- Iniciativa sobre inteligencia artificial y sistemas de alto riesgo (17 de junio de 2026) — http://sil.gobernacion.gob.mx/Archivos/Documentos/2026/06/asun_5104326_20260617_1782169761.pdf
Si quieres que tu próxima automatización nazca con bitácora, citas y versionado desde el diseño, así trabajamos en IA y automatización. Empieza por el diagnóstico gratuito de 3 minutos y te decimos qué evidencia te falta hoy.